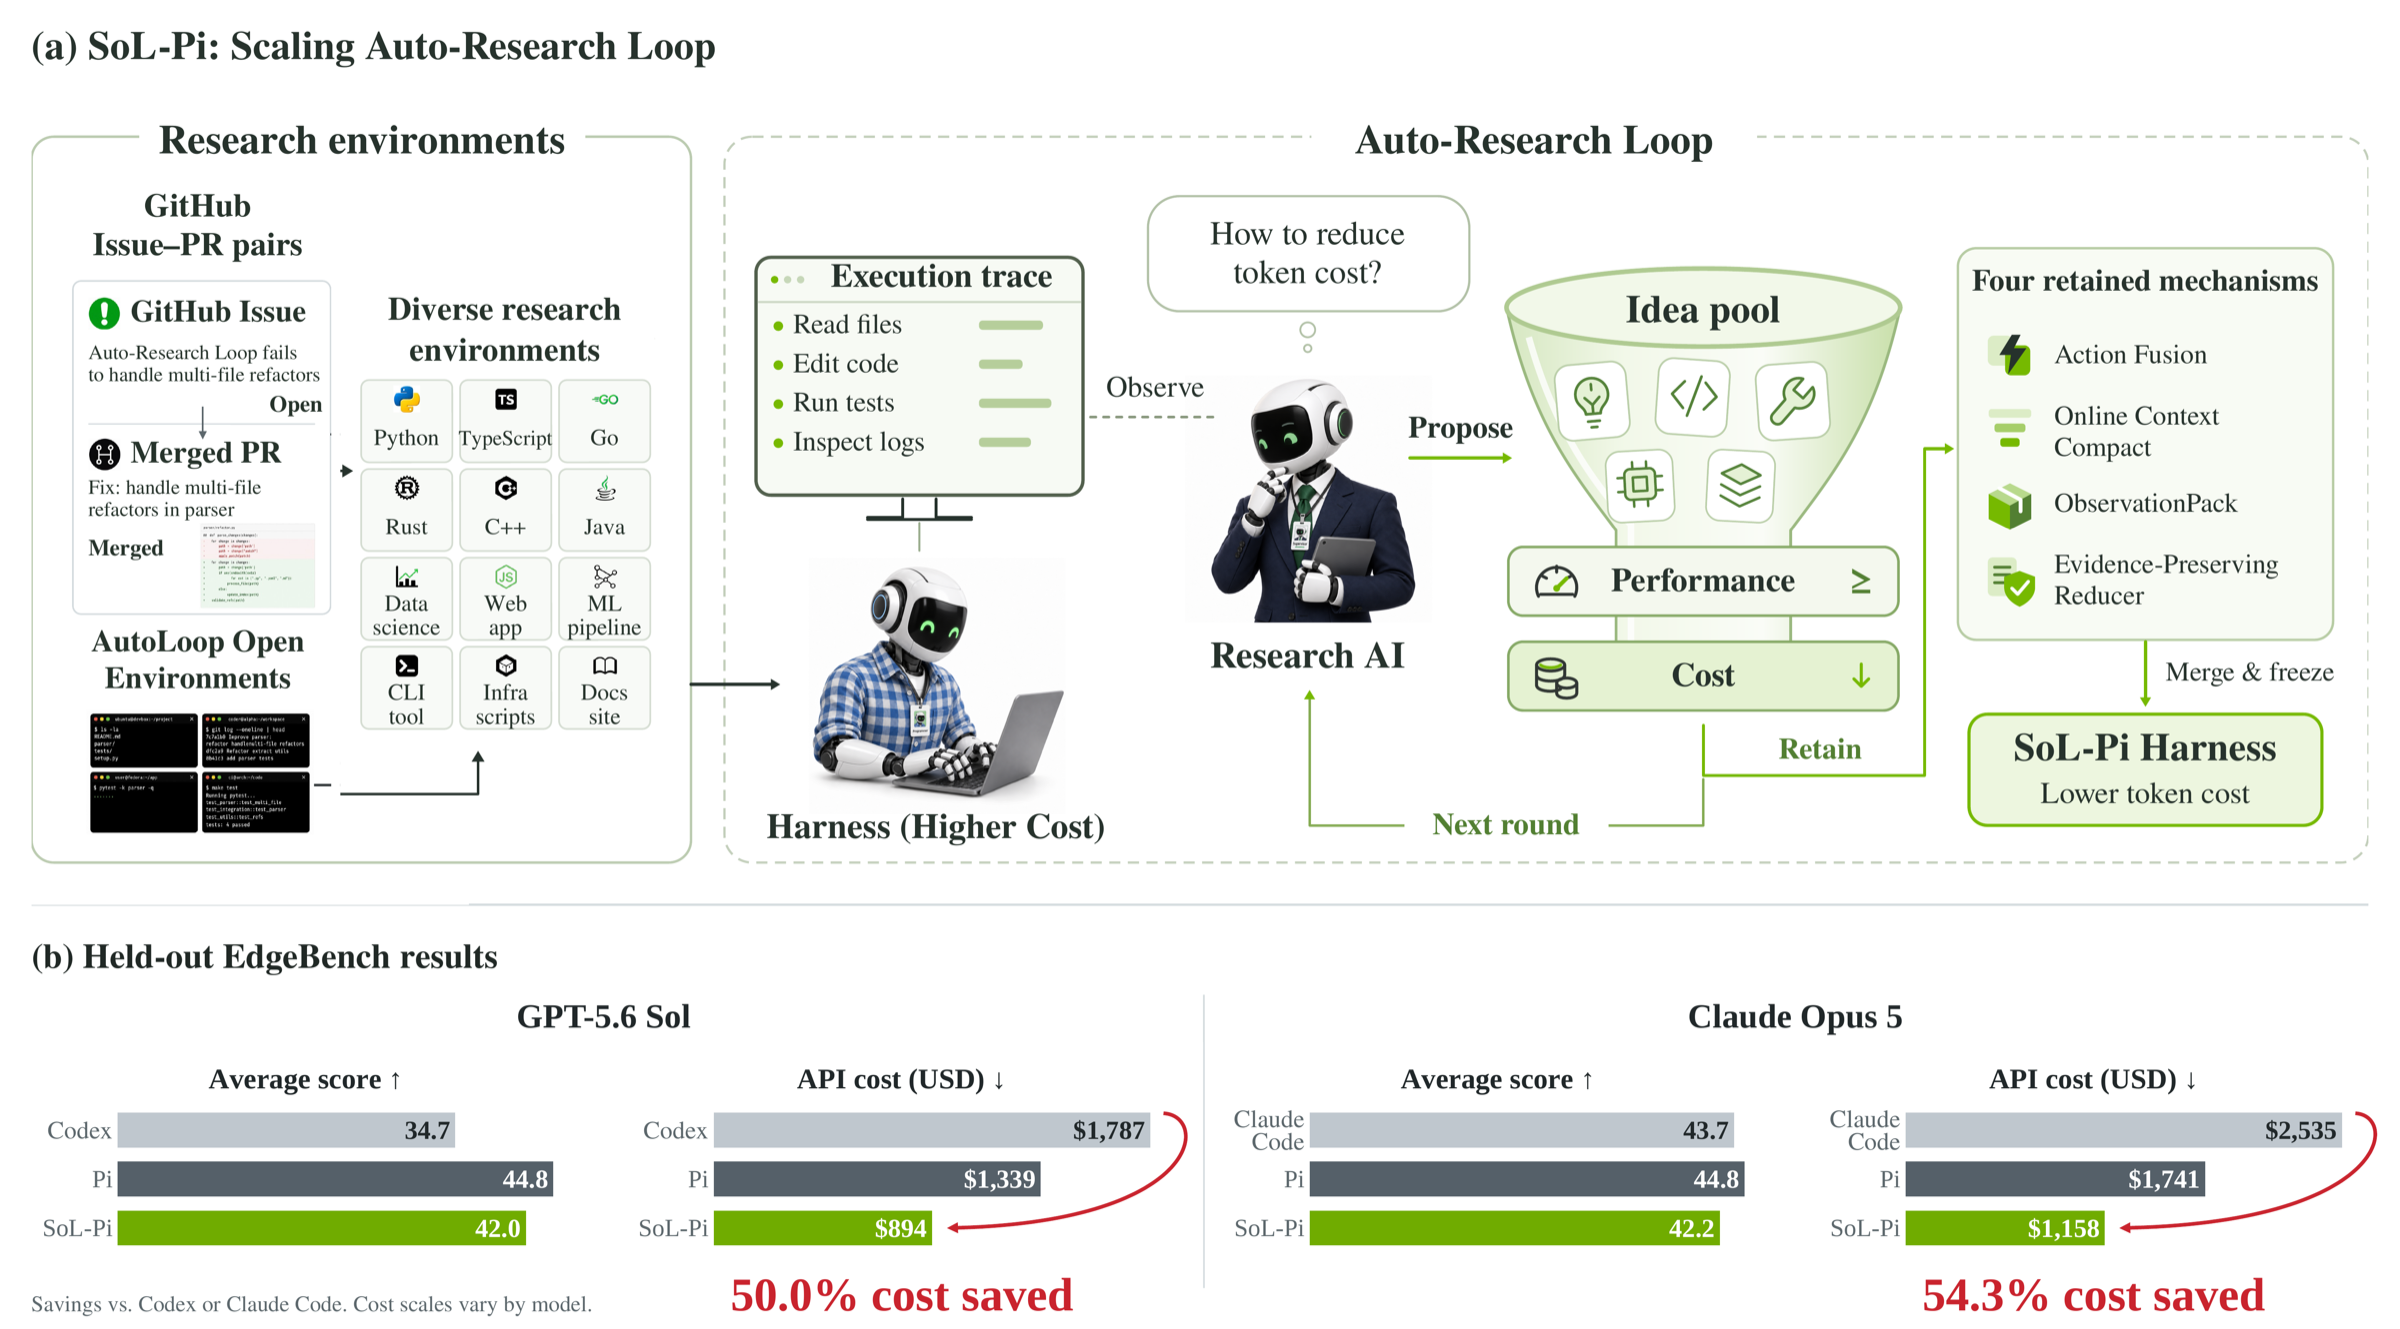
过去半年,我参与了 SoL-Pi。这个项目让 Coding Agent 自己提出、实现并验证对 Harness 的修改。方法和结果在项目主页上已经写清楚了。这篇文章写主页上没有的内容:项目最初从哪里开始,先失败在哪里,以及做完之后我们对 Harness 和多 Agent 系统的一些看法。
其中一部分有实验数据支持,一部分是个人判断,文中会分开说明。
起点:在固定 Benchmark 上做自改进
2026 年 3 月前后,让 Agent 改进自己的 Harness 开始受到关注。Meta-Harness [Lee et al. 2026] 让 Coding Agent 读取之前所有候选方案的代码、分数和执行轨迹,再提出新的修改。Self-Harness [2026] 从执行轨迹里找出失败模式,提出小改动,只有在 held-out 任务上不退步才接受。那个春天,我们在内部复现并扩展了这类方法,反复遇到两个问题。
第一,搜索不稳定。 我们按 Meta-Harness 的方式跑,100 次修改里真正有效的不到 5 次。大部分修改都是噪声,最后留下什么,主要取决于筛选。而在固定任务集上筛选,只要能提高这个任务集的分数,修改就会被留下,包括那些把题目特征直接写进规则的修改。没有人故意这样做,但候选一多,搜索自然会找到刷分的办法。
第二,held-out 检验说明不了太多。 Self-Harness 把 Terminal-Bench 2 拆成两部分,一部分用来优化,另一部分留作 held-out。这比不拆分好得多。但两部分出自同一个 Benchmark,出题人、容器约定和验证器写法都一样。在 held-out 部分上提分,只能说明改动在同一分布内有效,很难说明它对用户自己的代码仓库有没有帮助。
所以我们的结论是:目标选错了,搜索算法再好也没用。如果目标是某个任务集上的分数,能力足够强的优化器迟早会把这个任务集本身学进去。
选一个与具体任务无关的目标
我们把目标换成了 token efficiency,也就是每得一分要花多少 API 成本,同时要求能力不能低于下限。
选它的原因是,它要消除的浪费大多来自 Harness 本身,和做什么任务关系不大。比如,同一段上下文每次请求都要重新发送;模型改完文件,要先花一轮读修改结果,才发出早已想好的测试命令;一份 200 KB 的构建日志,在后面每次请求里都被重新传一遍。不管 Agent 是在写 SQLite WAL 解析器还是 Raft 集群,这些情况都会出现。能消除这类浪费的机制,即使没见过目标任务,也有理由在新任务上起作用。
效率目标也有捷径:Agent 少做事,token 自然就少了。所以我们先设了能力门槛。搜索开始前,先规定每项能力指标允许下降多少。只有所有指标都在允许范围内,省下的 token 才算数。
第二个要求是搜索和评测严格分开:
- 搜索用的是 535 个环境。其中 495 个来自 GitHub 的 issue–PR 配对,另外 40 个是开放式任务,由验证器打分,分数在 0 到 1 之间。
- EdgeBench [Seed 2026] 完全不参与搜索。候选冻结后只评测一次,没通过就淘汰,结果也不会反馈给搜索过程。
第三个原因比较实际:效率提升能直接让用户少花钱,Agent 还是原来那个。我们希望研究做出来的东西,用户能直接装上用。
最后,我们一共尝试了 152 个研究方向,运行 3,000 多次,Agent 交互 60,000 多次,留下 4 个机制。在 EdgeBench 上用 GPT-5.6 Sol 时,四个机制合在一起,比 Pi 少用 49.0% 的 token、少花 33.2% 的 API 成本,分数保留 Pi 的 93.7%。不做任何新的搜索,直接换到 Opus 5 上,token 少 44.7%,成本少 33.5%,分数保留 94.3%。省钱也有代价:在 Terminal-Bench 4 上,成本降了 26.3%,但解出的任务从 18 个降到 15 个。这个取舍应该如实写出来。
为什么选 Pi
我们选 Pi 作为起点,有四个原因。
- 核心足够小。 Pi 只有读、写、编辑和 bash 四个基本工具,外加一套扩展机制。Agent 动手修改之前,可以先把整个 Harness 读完。
- 性能比预想的好。 我们内部做了大量测试,Pi 在多个 Benchmark 上超过了我们对比的厂商自带 Harness。起点本身就不低。
- 它本来就是为 Agent 修改而设计的。 Armin Ronacher 把 Pi 的设计思路概括为 “agents built for agents building agents”:Agent 可以 “write code, reload, test it and go in a loop until your extension actually is functional” [Ronacher 2026]。自改进 Harness 需要的正是这种循环。
- 它有真实用户。 改进 Pi,成果可以直接交到已有用户手里,不止写成一篇论文。
模型越强,Harness 就该越薄吗?
常见的说法是:模型越强,Harness 就该越薄,模型自己能做的都应该删掉。我觉得这里混了两个问题。一个是模型能不能只靠基本操作把事做完,另一个是这样做是不是最省。
可以拿处理器做对照。任何计算都能用一套很小的指令集表达,但处理器依然有向量单元和专门的加密指令,因为常见的计算走专用路径要便宜得多。指令集设计争论了几十年,争的始终是哪些专用设计划得来,没有人怀疑基本指令够不够用。Harness 也一样。简洁确实有价值,但简洁本身不能证明设计最好。
SoL-Pi 里有一个具体例子。不加任何新工具,模型也可以先改文件、看修改结果,再发测试命令。但中间那一轮其实没有做任何决定,因为改之前就已经知道要跑哪条测试。Action Fusion 让模型在一次调用里同时给出修改和后续命令,Harness 依次执行,然后把两步的结果一起返回。我们在已有轨迹上做了 oracle 分析,估计如果这种写法用满,可以减少 10.8% 的模型调用轮次和 11.5% 的 token。模型完全能按原来的方式做,Harness 只是让它做得更省。
同样的实验也显示,一套固定的 Harness 解决不了所有问题。机制能省多少,要看模型实际怎么调用它。在触发过 Action Fusion 的任务里,GPT-5.6 Sol 平均每个任务触发 70.58 次,Opus 5 只有 13.54 次。Online Context Compact 在 Sol 的 92.2% 的任务里触发过,在 Opus 5 上只有 33.3%。设计时写死的机制,对有些模型很合适,对另一些模型就用得少。
所以更该问的是:哪些复杂设计划得来,对哪个模型划得来,而且要按完成整个任务的成本来算。Harness 是厚是薄,回答不了这个问题。
“Harness 会越来越薄”这个说法,还漏掉了一种可能。它只考虑了模型把 Harness 的功能学进去这一条路。另一条路是,模型越强,越会用基本操作给手头的任务搭工具。SoL-Pi 的四个机制都是 Agent 自己提出、实现和验证的。这个例子不大,但问题的问法因此变了:除了问“这件事能不能交给模型”,还可以问“模型能不能做出比我们事先写好的更合适的工具”。
顺着这个思路,Harness 可以这样分层:底层是一个小而稳定的核心,只提供基本操作;上层根据任务组合工具,用得越多改得越好。核心保持简单,复杂的部分放在可以变化的地方。多 Agent 系统也可以这样做。不同角色的 Agent 不必用同一套 Harness,每个成员的 Harness 可以随角色和任务阶段调整。
怎样判断递归改进有没有进展
判断递归改进有没有进展,有两种直观的办法,但都容易看错。
看跑了多少轮。 多跑一轮很便宜。关键是这一轮有没有做出以前做不出的东西:原来解不了的题有了解法,某个机制通过了 held-out 评测,或者得到了质量更高的训练数据。在 SoL-Pi 里,大约 40 个初始想法才有 1 个通过验证。用 GPT-5.6 Sol 顺着一个想法往深处改,5 到 10 轮之后,基本只是在同一个设计上做小修小补。最后通过验证的机制,来自更多互相独立的起点。这是我们的定性观察,没有在相同预算下对比过两种做法。
看成果能不能一直留下来。 经常有人说“基座模型迟早会学会”,以此否定 Harness 研究。这句话其实混了两个问题:某个具体实现能不能长期留下来,以及它有没有帮助产生以前没有的能力。Harness 可以先帮系统解出一类题,这些解法再变成训练数据;模型学会以后,这个 Harness 就可以不要了。这条路本来就是这样设计的。这也意味着,没有资源训练最大的模型,照样可以研究怎样让模型进步。一种方法如果能稳定地产出新的高质量结果,即使后面的训练由别人来做,这个方法本身也是研究贡献。
效率可能会越滚越大。 我们计划下一步用 SoL-Pi 作为新一轮 Auto-Research 的起始 Harness。每次运行便宜三分之一,同样的预算就能多试一些环境、轨迹和想法。这样一来,被优化的不只是做任务的过程,还包括寻找下一项优化的过程。这还是一个研究方向,我们还没有证明收益能一轮一轮累积下去。
Agent 多了,投入也多了
在 SoL-Pi 的 Swarm 实验里,1 个协调者带 20 个 worker,用两小时优化一个 kernel。SoL-Pi Swarm 降到 1,127 cycles,花了 60.11 美元;由普通 Pi worker 组成的 Swarm 降到 1,366 cycles,花了 82.12 美元;单个 Agent 降到 1,333 cycles,只花了 39.20 美元,三者中最便宜。21 个 Agent 比 1 个 Agent 只少了约 15% 的 cycles。多花的钱值不值,要看具体问题。
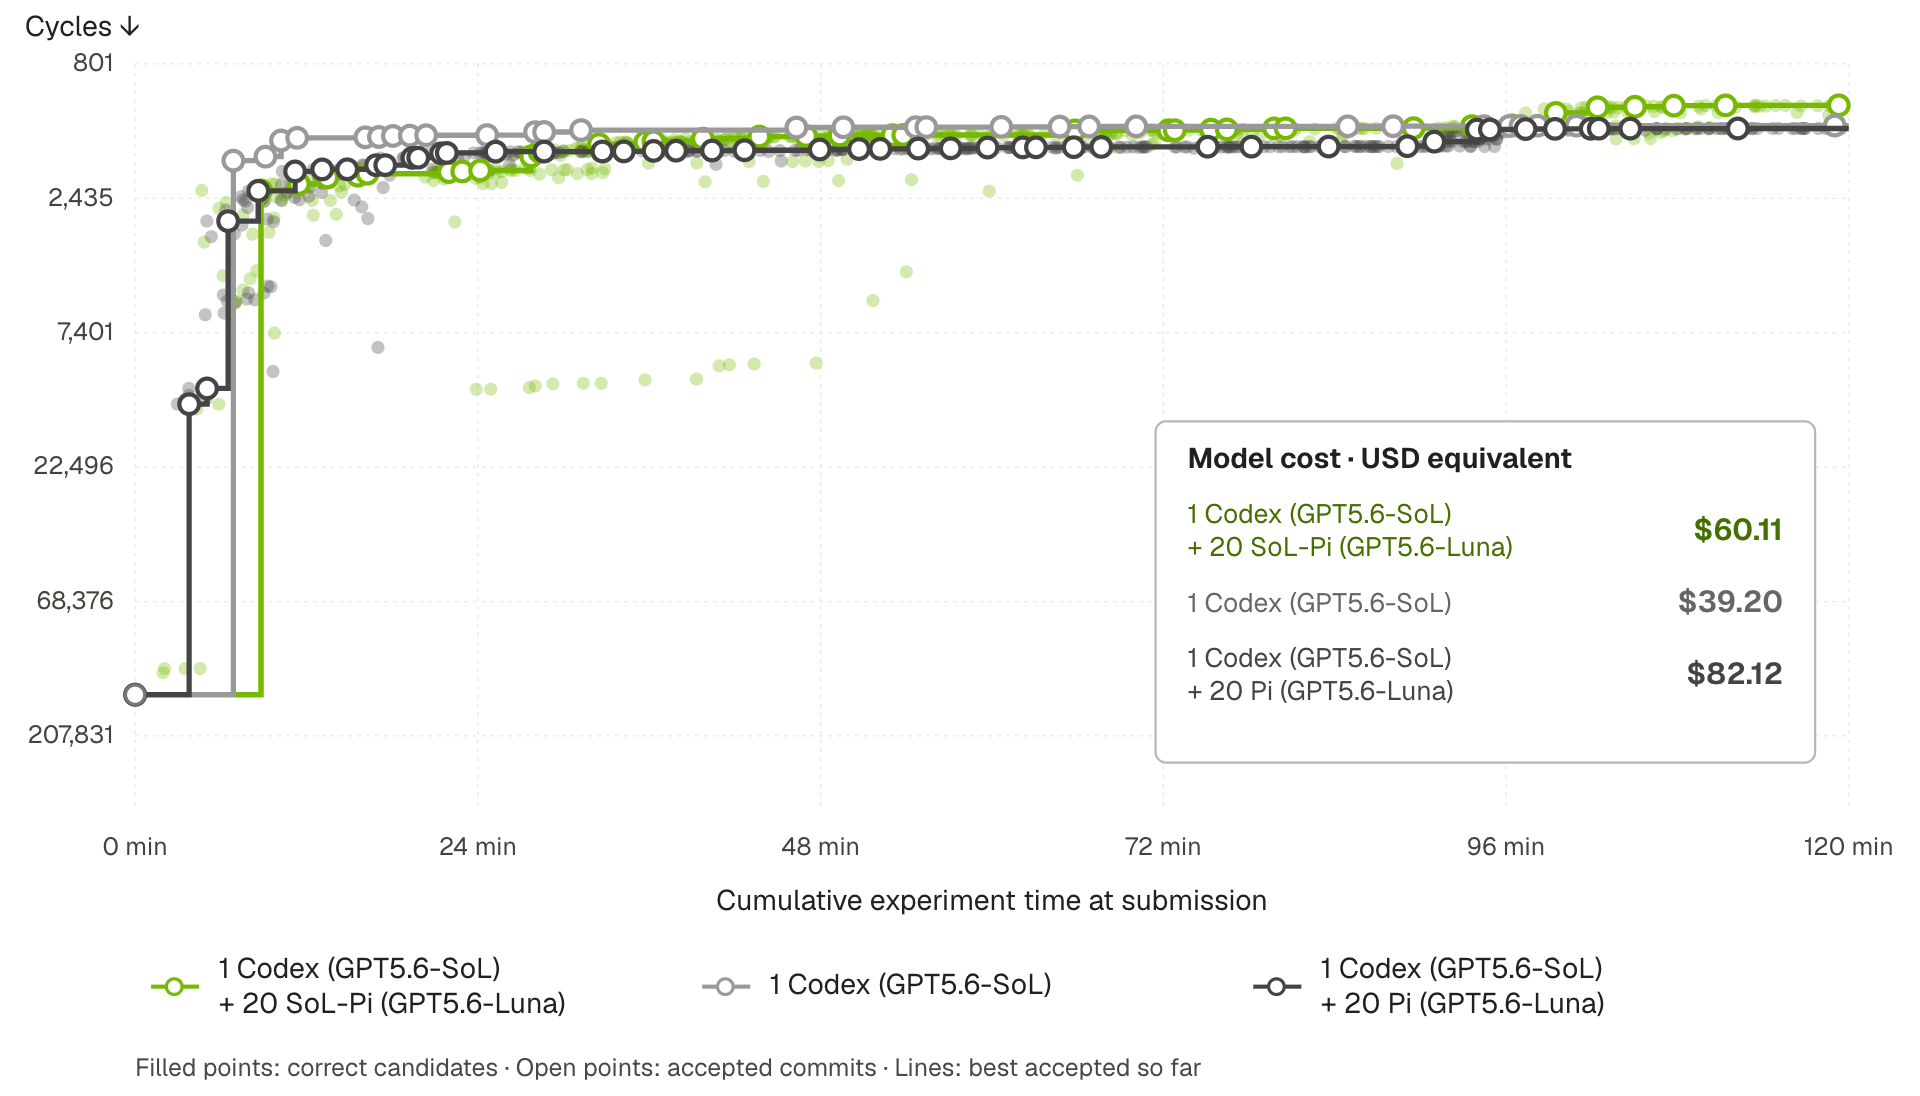 两小时内已接受方案的最优 cycles,越低越好。绿色:1 个 Codex 协调者加 20 个 SoL-Pi worker。浅灰:单个 Codex Agent。深灰:1 个 Codex 协调者加 20 个 Pi worker。
多加一个 Agent,就是多一份投入。能换回多少,取决于三件事:成员是否在探索不同方向;一个成员的发现,能不能让别人少做重复工作;协调本身要花多少。我们遇到过这样的情况:Agent 加多了,收益很小,通信开销却很明显。所以光是增加 Agent 数量,还算不上一个研究方案。真正要回答的是,什么样的协作方式能让多花的钱换来更多进展。
通信也要这样算账。在我们的运行里,加了通信以后,每一轮用的 token 有时更多,但需要的轮数少了,总量反而下降。一条消息值不值得发,要看它能不能让后面的工作更顺利,只数这条消息本身用了多少 token 是看不出来的。
不同的 Agent 也可以用不同的模型。把不同厂商的模型组合起来,是独立研究者更有优势的方向,因为厂商在优化自己的产品,没有多少动力让竞争对手的模型表现更好。更一般地说,能长期做下去的研究,往往是我们的目标和厂商目标不一样的问题。如果只是厂商暂时还没做的事,等他们投入资源,这个机会很快就没了。
结语
这个项目里,我觉得最值得记下的是三条:
- 评测奖励什么,搜索就会优化什么。只保留在没见过的任务上仍然有效的改动。
- 评价一个 Harness,看它完成整个任务的质量和成本,不看它是厚是薄。
- 判断递归改进有没有进展,看它产生了哪些新结果,不看跑了多少轮。
RSI for Efficiency. Efficiency for Swarm Intelligence.
参考文献
[1] SoL-Pi project page. https://nvlabs.github.io/SoL-Pi/
[2] Lee, Y., Nair, R., Zhang, Q., Lee, K., Khattab, O., and Finn, C. “Meta-Harness: End-to-End Optimization of Model Harnesses.” arXiv:2603.28052, 2026.
[3] “Self-Harness: Harnesses That Improve Themselves.” arXiv:2606.09498, 2026.
[4] Ronacher, A. “Pi.” 2026. https://lucumr.pocoo.org/2026/1/31/pi/
[5] ByteDance Seed. “EdgeBench.” arXiv:2607.05155, 2026. https://github.com/ByteDance-Seed/EdgeBench
[6] Weng, L. “Harness Engineering for Self-Improvement.” Lil’Log, 2026. https://lilianweng.github.io/posts/2026-07-04-harness/